Forstock : prévoir les mois suivants d'un lancement avec TimeGPT
Algorithme en production chez Forstock depuis début 2026. TimeGPT face à la méthode historique sur 1 241 lancements réels de 14 clients : -27 % de coût de mauvaise prévision après 4 mois de ventes, -48 % après 6 mois, erreur par lancement divisée par 2 à 2,7.
La situation
Une fois un produit lancé, la question devient : que va-t-il vendre les mois suivants ? C'est elle qui décide de la commande de réassort. L'algorithme est en production chez Forstock depuis début 2026. Je l'ai mesuré sur des lancements réels : 1 241 lancements après 4 mois de ventes et 1 090 après 6 mois, pour 14 clients, lancés de juin 2025 à janvier 2026.
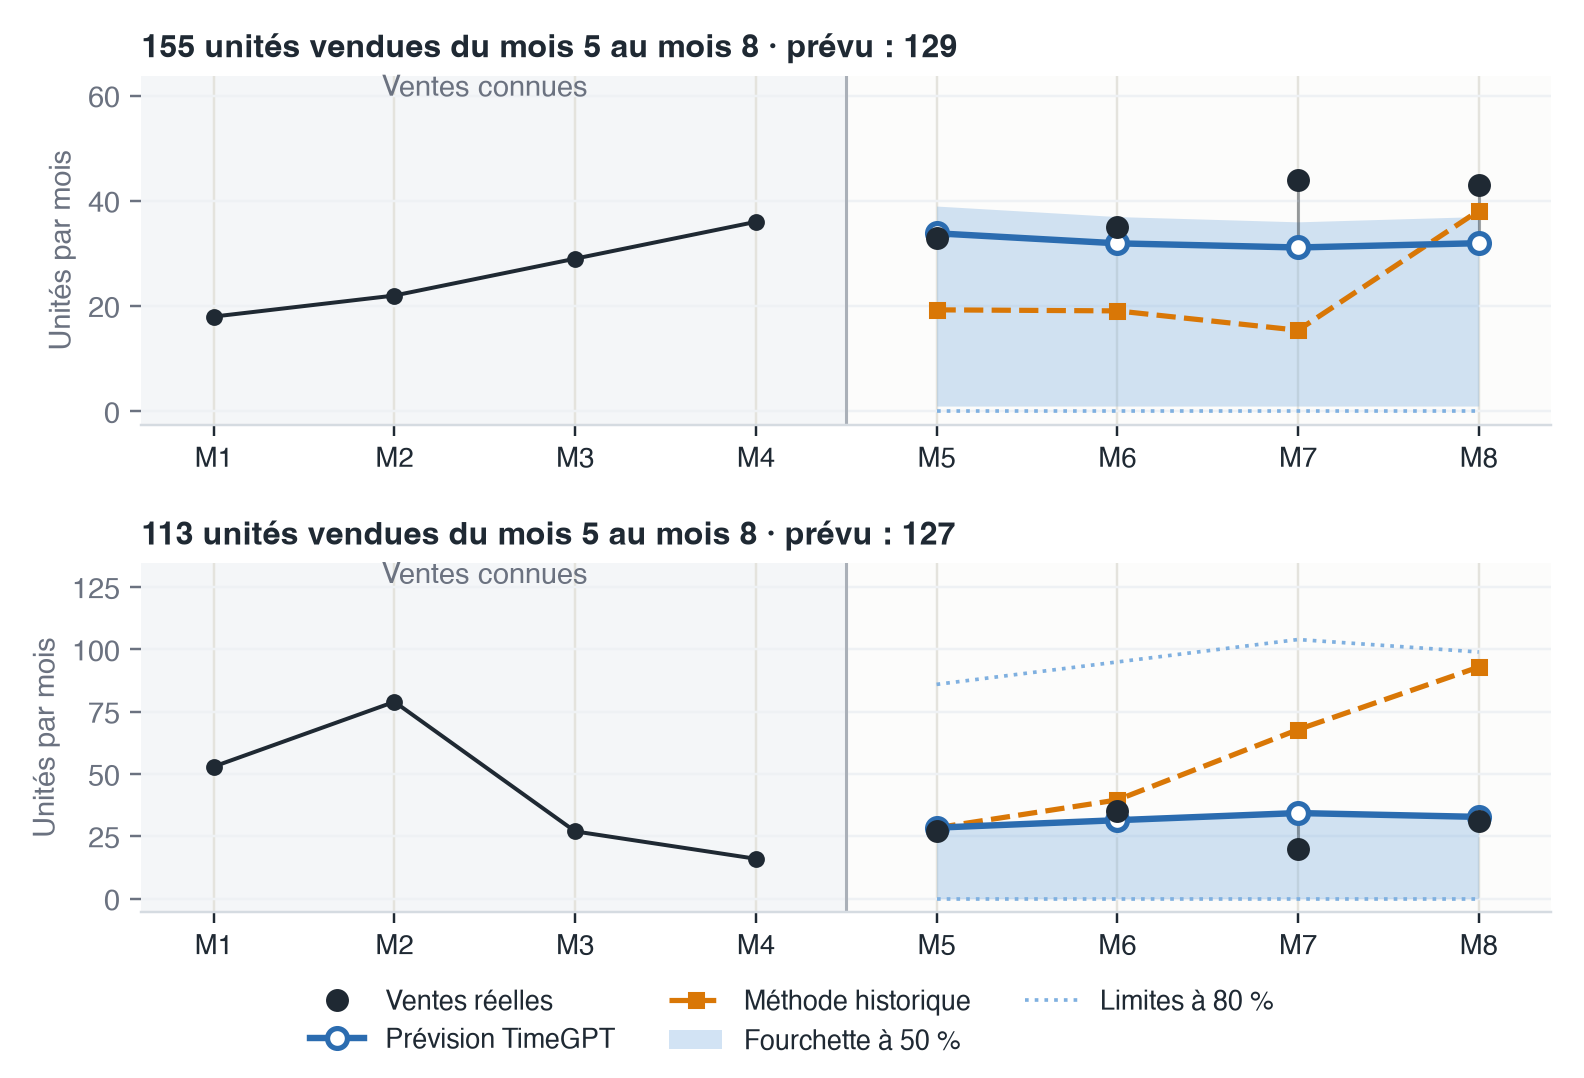
Deux lancements réels. Les 4 premiers mois (zone grisée) sont connus, les 4 suivants sont prévus puis comparés aux ventes réelles (points noirs). La méthode historique (orange) s'écarte du réel dès que la dynamique du produit change, TimeGPT (bleu) reste plus proche.
La méthode
- La référence : la méthode historique. Le volume à venir est le niveau récent des ventes du produit, appliqué à la saisonnalité de sa famille. Tous les gains sont mesurés face à elle.
- TimeGPT. Un modèle de prévision de séries temporelles pré-entraîné sur un très grand nombre de séries, appliqué sans réapprentissage à l'historique mensuel du produit : 4 ou 6 mois de ventes en entrée, les 4 ou 3 mois suivants en sortie.
- Une mesure honnête. Chaque lancement est prévu à la date de décision (après 4 ou 6 mois de ventes) avec uniquement les ventes connues à cette date, puis comparé aux ventes réelles des mois suivants. Les deux méthodes sont évaluées sur exactement les mêmes lancements.
- Une fourchette calibrée. TimeGPT fournit une prévision unique. J'en tire une loi de probabilité (loi binomiale négative) dont l'étalement est calibré sur des lancements différents de ceux évalués, puis une fourchette à 80 %. La même méthode est appliquée à la référence.
Des volumes plus justes
-
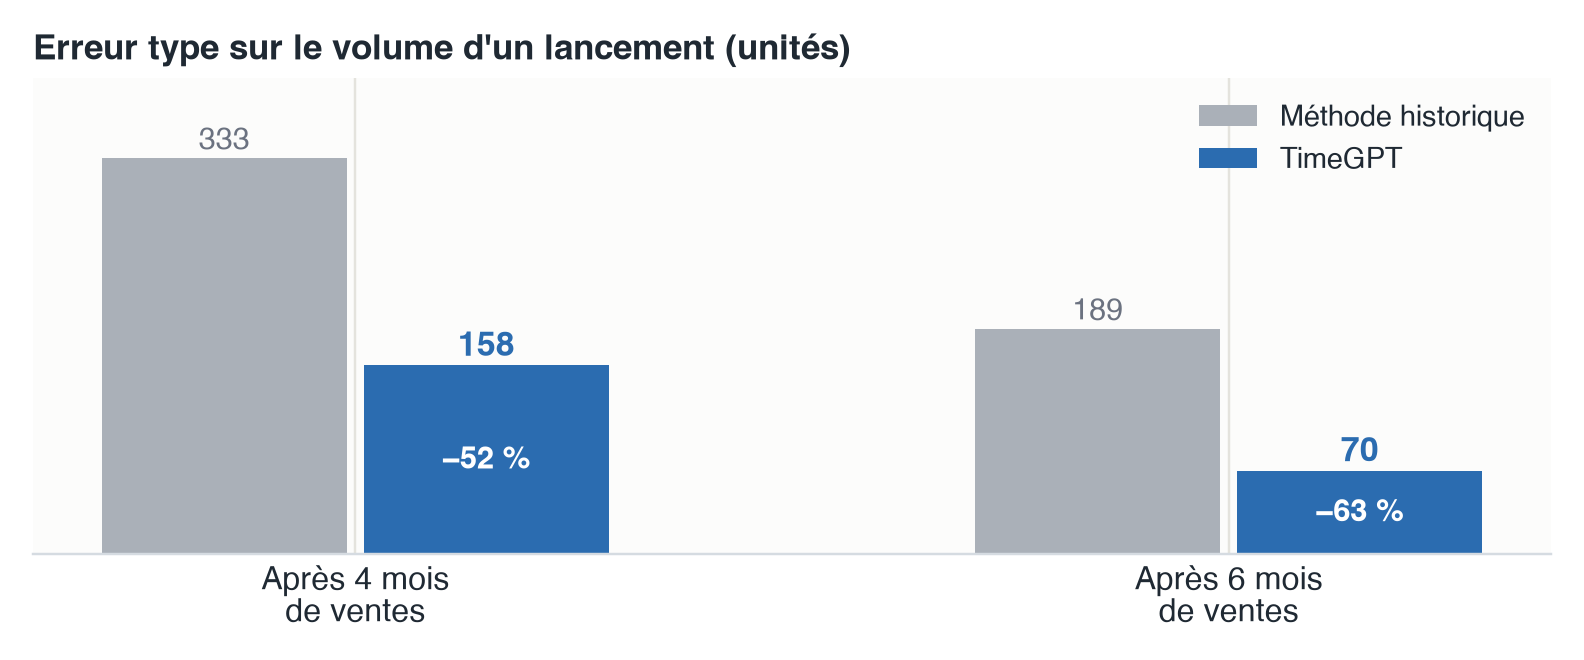
Par lancement, l'erreur type est divisée par 2 après 4 mois de ventes (333 → 158 unités, -52 %) et par 2,7 après 6 mois (189 → 70 unités, -63 %).
-
Par lot (les produits d'une même famille lancés le même mois dans une boutique), l'erreur passe de 165 % à 108 % après 4 mois, et de 167 % à 82 % après 6 mois.
-
Sur le volume total, la surestimation passe de +123 % à +73 % après 4 mois, et de +135 % à +69 % après 6 mois.
-
64 % des lancements sont mieux prévus par TimeGPT que par la méthode historique après 6 mois (56 % après 4 mois).
La méthode historique prolonge le niveau récent et la saisonnalité de la famille : elle s'écarte du réel dès que la dynamique du produit change. TimeGPT lit la forme de la courbe du produit et reste plus proche des ventes réelles.
Une fourchette plus étroite
| Fourchette à 80 % | Largeur, référence → TimeGPT | Ventes réelles dans la fourchette (cible 80 %) |
|---|---|---|
| Après 4 mois de ventes | 278 → 208 unités (-25 %) | 90 % → 87 % |
| Après 6 mois de ventes | 182 → 118 unités (-35 %) | 92 % → 90 % |
À fiabilité comparable, la fourchette autour de la prévision TimeGPT est plus étroite d'un quart à un tiers que celle de la référence.
Ce que cela vaut en euros
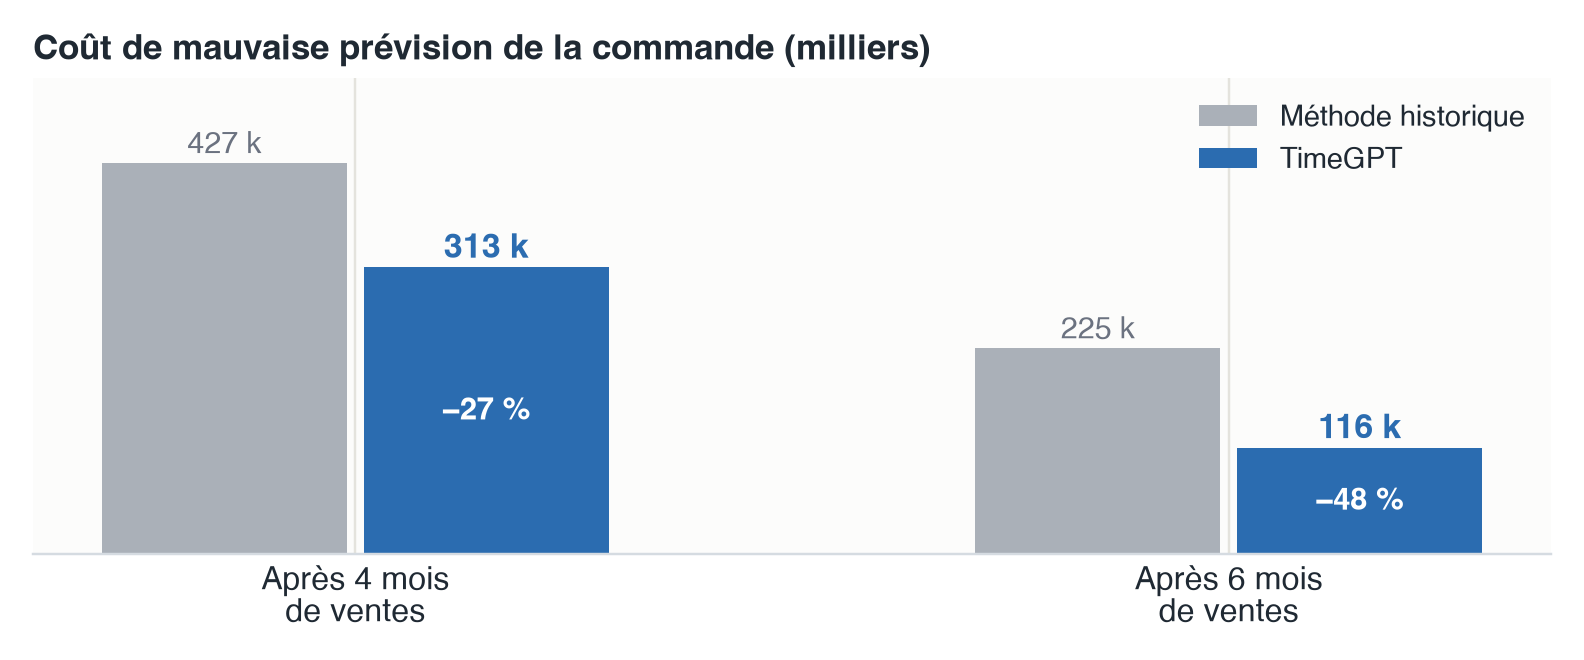
Pour chaque lancement, je simule la commande couvrant les mois suivants (4 mois à la décision de 4 mois, 3 mois à celle de 6 mois), égale à la prévision, avec les prix et coûts unitaires du catalogue. Le coût de mauvaise prévision est la marge perdue sur les ventes manquées, plus le coût du surstock (30 % du coût d'achat de chaque unité en trop).
| Commande = prévision | Méthode historique | TimeGPT | Gain |
|---|---|---|---|
| Après 4 mois de ventes (1 241 lancements) | 427 k | 313 k | 114 k (-27 %) |
| Après 6 mois de ventes (1 090 lancements) | 225 k | 116 k | 109 k (-48 %) |
| Unités en surstock, 4 mois / 6 mois | 81 763 / 46 222 | 53 833 / 24 972 | -34 % / -46 % |
| Unités manquantes (ruptures), 4 mois / 6 mois | 15 519 / 7 568 | 14 751 / 5 153 | -5 % / -32 % |
Ces gains se comparent à 941 k (4 mois) et 498 k (6 mois) de chiffre d'affaires réalisé sur ces lancements pendant la période prévue.
Les montants sont valorisés à partir des coûts d'achat du catalogue et exprimés dans la devise de chaque boutique.
Résultats mesurés
-27 %
Coût de mauvaise prévision, après 4 mois de ventes
-48 %
Coût de mauvaise prévision, après 6 mois de ventes
-52 % / -63 %
Erreur par lancement, après 4 mois / 6 mois
167 % → 82 %
Erreur sur un lot, après 6 mois